
En résumé
- Le 30 octobre 2026, les Meta Commercial Terms autorisent Meta à explorer les pages liées à votre activité si vous utilisez encore un produit Meta à des fins pro.
- Meta dit avoir retiré le mot « entraîner » du texte. Le droit de crawler reste, et la clause ne parle pas du robots.txt.
- Bloquez
meta-externalagent. Laissezfacebookexternalhit,meta-webindexeret, si vous faites de la pub,meta-externalads. - Un
Disallow: /surUser-agent: *ne protège pas de l’IA. Il coupe Google.
Une Page Facebook ouverte en 2019 « juste pour être présent » suffit. Pas besoin d’avoir dépensé un euro en publicité.
Le 30 octobre 2026, continuer à l’utiliser vaut acceptation des conditions commerciales Meta. Meta, ou une entité qui agit pour lui, peut envoyer des robots sur les URL associées à vos produits ou services. Le but écrit : fournir, développer et maintenir les produits publicitaires et business, plus la sécurité.
Meta dit avoir retiré « entraîner » de l’aperçu autour du 20 octobre, mais toutes les éditions du texte n’ont pas suivi au même rythme. « Développer » reste large, et le droit d’accès n’a pas bougé.
Pourquoi « on bloque tout Meta » rate la cible
Meta ne frappe pas avec un seul robot. Sa documentation en décrit cinq, et un Disallow sur l’un ne dit rien aux quatre autres.
Le robots.txt, selon le RFC 9309, est une préférence d’accès, pas une serrure. Gary Illyes (Google) l’a redit le 21 octobre 2026 : le fichier dit quelles URL demander, pas quoi faire des données déjà prises. Search Engine Journal résume l’épisode.
Un fichier publié le 29 octobre ne rapatrie rien. Deux robots Meta peuvent en plus l’ignorer.
Un cas type
Pas un témoignage. Le schéma d’une PME de services, vu et revu.
WordPress, Page Facebook pour les horaires, robots.txt Yoast ou Rank Math : User-agent: *, /wp-admin/ fermé, admin-ajax.php ouvert. Aucune ligne meta-externalagent. Le dirigeant est sincère : sans pub, il se croit hors sujet.
Le 31 octobre, il poste les congés. L’usage continu vaut acceptation, et le site n’a rien dit au robot d’entraînement.
Quarante-huit heures plus tard, quelqu’un colle Disallow: / sous User-agent: * « pour couper l’IA ». Googlebot s’arrête, et les partages Facebook perdent image et titre.
Quel robot bloquer, et lesquels laisser passer
| Robot | Rôle (selon Meta) | Conseil pour une PME |
|---|---|---|
meta-externalagent | Entraîner des modèles, ou indexer pour améliorer des produits | Bloquer |
meta-webindexer | Améliorer les réponses Meta AI, qui citent vos pages avec un lien | Laisser |
facebookexternalhit | Aperçu : titre, description, image | Laisser |
meta-externalads | Publicité et produits business | Laisser si vous faites ou prévoyez de la pub |
meta-externalfetcher | URL demandée par un utilisateur ou un agent | Inutile d’y croire : il peut ignorer le fichier |
Une PME qui vit d’être trouvée n’a aucun intérêt à sortir de Meta AI pour « protéger » une page écrite afin d’être citée. C’est du GEO à l’envers.
Bloquer meta-externalads pendant que vos pubs pointent vers le site est l’autre classique. La clause du 30 octobre vise ces produits-là, pas le même métier que l’entraînement. Vous demandez à l’outil qui vend l’offre de moins bien la lire.
facebookexternalhit peut passer outre lors d’un contrôle de sécurité. meta-externalfetcher peut passer outre parce qu’un utilisateur a demandé l’URL. Comptez jusqu’à 24 heures de cache après chaque modification : Meta le dit dans sa doc, un test à trois minutes ne prouve rien.
Pourquoi les autres méthodes échouent
Le bouton « bloquer tous les bots IA » coupe souvent GPTBot, ClaudeBot, PerplexityBot et Google-Extended ensemble. Vous sortez des citations, alors que le GEO consiste à y entrer.
Google-Extended n’est pas un visiteur. Google crawle avec Googlebot, et ce jeton ne sort pas le site de la recherche. C’est dans la liste officielle des crawlers.
Une règle Cloudflare « Block AI bots », trop large, casse des aperçus sans résilier le moindre contrat. Le noindex, lui, parle à Google : une URL seulement interdite dans le robots.txt peut rester connue par un lien, et le robot n’ouvrira jamais la balise puisqu’il n’ouvre pas la page.
Vos mentions légales ne retirent pas l’autorisation donnée via la Page. Autre document, autre signataire. Et bloquer seulement l’ancien FacebookBot rate meta-externalagent : le badge a changé de porte.
Dernier raté, très WordPress : deux fichiers qui se contredisent. Un robots.txt envoyé par FTP prend le dessus sur celui de Yoast ou Rank Math, et la ligne ajoutée dans l’extension ne s’affiche alors jamais. Vérifiez toujours le résultat à l’adresse publique, pas dans l’extension.
Le bloc à coller, et celui qu’il ne faut pas coller
Site vitrine ou boutique qui doit rester partageable : partez de là, puis adaptez.
User-agent: meta-externalagent
Disallow: /

User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Le groupe nommé va au-dessus du groupe étoile. Un crawler conforme ignore l’ordre. Pas la personne qui rouvrira le fichier dans six mois.
Ne collez jamais ceci :
User-agent: *
Disallow: /
Vous demandez à Googlebot et à Bingbot de ne plus lire le site. Aucun référencement ne s’en remet.
Sans pub Meta, et sans projet d’en faire, meta-externalads peut être bloqué dans son propre groupe.
User-agent: meta-externalads
Disallow: /
Un média qui vend son texte peut aussi fermer meta-webindexer. Un artisan ou un cabinet, non : sa page doit circuler, à condition de renvoyer chez lui. Laissez facebookexternalhit, sinon le partage de votre dernière réalisation sort sans image.
Ce que le fichier ne fera jamais
Il n’efface pas ce qui est déjà collecté. Il évite, au mieux, la prochaine visite d’un robot qui le respecte.
Il ne résilie pas les conditions. En sortir suppose d’arrêter l’usage pro des produits Meta concernés. Ce n’est pas un conseil juridique : le texte qui fait foi est celui de Meta, version française comprise.
Il ne rend pas une page citable. Sans réponse claire en tête, ou rendue seulement en JavaScript mal exécuté par les robots, le trou est ailleurs. La serrure, c’est le fichier ; la vitrine, c’est la création de site qu’on fait chez Karuweb.
Comment vérifier sans se raconter d’histoires
Ouvrez https://votredomaine.fr/robots.txt. Une 404, ce n’est pas un verrou. C’est l’absence d’interdiction nommée.
Sans la chaîne meta-externalagent, cet agent suit le groupe *, donc presque tout le public sur un WordPress standard. Dans les logs, cherchez meta-externalagent/1.1, pas le widget « bots IA : 0 ».
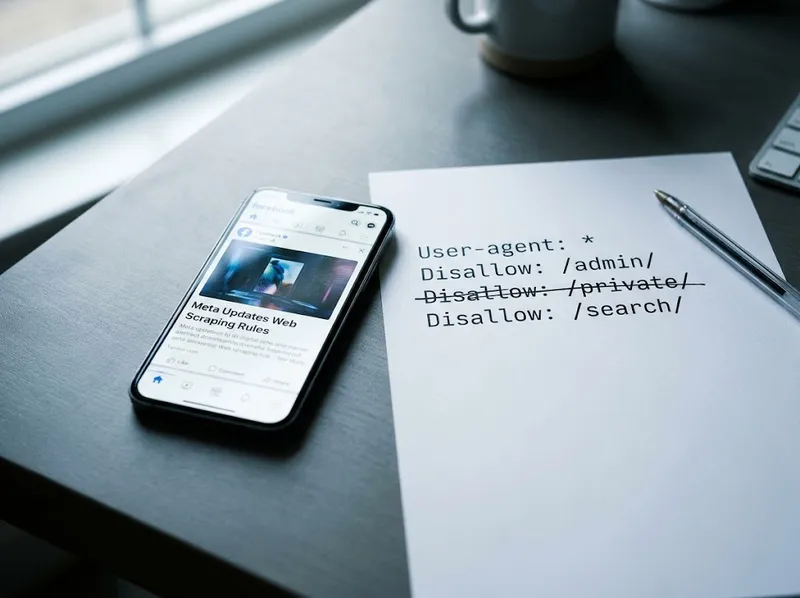
Attendez 24 heures, puis partagez une page. Titre et image présents : facebookexternalhit travaille. Absents après le ménage, vous avez bloqué le mauvais robot, une régression plus fréquente qu’on ne le croit.
FAQ
Faut-il écrire meta-externalagent/1.1, avec la version, et en minuscules ?
Écrivez meta-externalagent, sans version. Selon le RFC 9309, le robot se reconnaît à ce nom, sans tenir compte des majuscules.
/1.1 dans le fichier rate souvent la correspondance : on écrit le nom du robot, pas la chaîne des logs. Le groupe ne couvre ni meta-externalfetcher ni meta-webindexer.
Pourquoi un Disallow: / sur meta-externalfetcher n’est-il pas un contrôle d’accès ?
Meta documente l’exception : ce fetcher peut ignorer le robots.txt si un utilisateur, ou un agent pour lui, demande l’URL. Le RFC 9309 est une préférence, pas une authentification.
facebookexternalhit a une exception voisine, limitée à la sécurité et à l’intégrité. Pour qu’une URL ne sorte jamais, ne la publiez pas : 401, 403, ou pas de ressource.
Bloquer Google-Extended sort-il les pages des AI Overviews sans toucher au crawl ?
Non. Ce jeton n’a pas de user-agent HTTP propre. Google crawle avec Googlebot, et Google-Extended ne change ni l’inclusion ni le classement dans la recherche.
AI Overviews et AI Mode s’appuient sur ce crawl. Le levier pour en sortir sans quitter les résultats classiques est le réglage Search Console sur l’IA générative. Couper Googlebot retire la page des résultats.
Ce qu’il faut faire avant le 30 octobre
Écrivez meta-externalagent. Laissez les aperçus, Meta AI et, si vous investissez, le robot pub. Relisez le fichier après chaque mise à jour de l’extension SEO : vérifiez que la ligne est toujours là.
Si plus personne ne sait quel groupe gagne, on le reprend. Contactez Karuweb, appelez le 07 82 38 97 01 ou écrivez à contact@karuweb.fr. Fichier, logs, et ce que le site a intérêt à montrer.
Un site citable, pas seulement bloqué : page agence web, détails et tarifs, portfolio. La veille suit sur le blog.